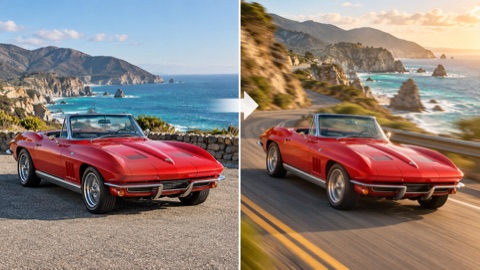
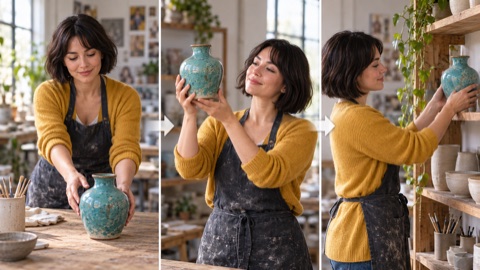
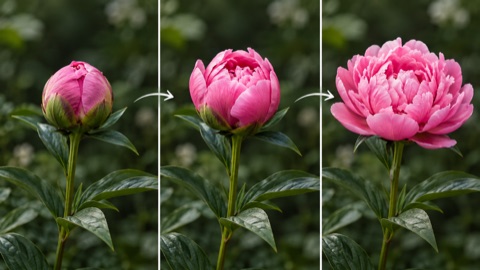
画像を基準に動きを生成
開始画像とプロンプトを組み合わせ、被写体やカメラの動きを指定します。
Wan 2.2 I2V 14B とカスタム LoRA を使って、静止画に動きを加えましょう。画像からの動画生成に、動きや映像のスタイル、モデルの表現を調整する機能を組み合わせたオンラインツールです。
開始画像をアップロードし、実現したい動きを記述して、互換性のある LoRA を設定します。LoRA は小さな追加の重みを使い、別のベースモデルを丸ごと用意せずに、特定の動作やスタイルへ表現を調整できます。
デモは第三者の Hugging Face Space が共有 GPU 上で提供しています。稼働状況、処理時間、1 日の利用枠は変わる場合があります。

このデモは Hugging Face 上の第三者が運営しています。GPU の待ち時間と利用枠があります。私的な画像や機密性の高い画像はアップロードしないでください。
切り替えるとデモが再読み込みされ、現在の入力は消去されます。必要な結果を先にダウンロードしてください。
デモの状態を確認中…
被写体が明確で、動くための余白がある開始画像を選びます。
被写体の動作、カメラワーク、映像の細部を記述します。まずは簡単な動作を 1 つ指定しましょう。
対応プリセットか Hugging Face の LoRA リポジトリを使います。高ノイズ用と低ノイズ用のファイルを求められたら、それぞれに合う重みを選びます。
利用可能な長さ、推論ステップ数、LoRA の強度を設定します。短い動画から始め、設定は 1 つずつ変えましょう。
処理を送信し、GPU の割り当てと生成を待ちます。完成後はデモ内の操作で動画を確認し、ダウンロードします。
LoRA(Low-Rank Adaptation)は、比較的小さな追加の重みで既存の AI モデルを適応させる技術です。
Wan 2.2 の画像から動画への生成では、対応する LoRA によって動きや映像表現を調整できます。高ノイズ段階と低ノイズ段階に別々の重みを用意するアダプターもあります。
互換性はベースモデル、アダプターの形式、推論の実装に依存します。すべての Wan LoRA が、すべての Wan 2.2 ワークフローで使えるわけではありません。
開始画像とプロンプトを組み合わせ、被写体やカメラの動きを指定します。
対応する重みと強度を試し、動きやスタイルを調整できます。
ローカルの生成環境をインストールせずに第三者のデモを使えます。処理は Space 側で実行されます。
埋め込みの Hugging Face ZeroGPU デモは、共有 GPU の空き、アカウントの利用枠、待ち行列の制限内で利用できます。Wan2.Video はページの利用料を請求しませんが、Hugging Face へのログインや再試行が必要な場合があります。
いいえ。モデルの構造と推論環境が要求する形式に依存します。対応する Wan 2.2 画像から動画生成用のアダプターを選び、その読み込み手順に従ってください。
通常はベースモデルとテキストプロンプトを使います。LoRA を使う場合は、対応する追加の重みを読み込み、出力の特定の特徴を調整します。
公式 Wan2.2-I2V-A14B モデルは 480p と 720p の生成に対応しています。ただし、このデモで選べる解像度は実装に依存するため、生成前に設定を確認してください。
動画生成には大量の GPU 計算が必要です。解像度、長さ、推論設定、Hugging Face の待ち行列も処理時間に影響します。まず短い動画で試すと確認しやすくなります。
いいえ。このページは第三者のコミュニティデモを埋め込んだ独立した情報ページです。Wan AI の公式サービスではありません。アップロードと処理は選択した Hugging Face Space が担当します。