Vidu S2 是什么
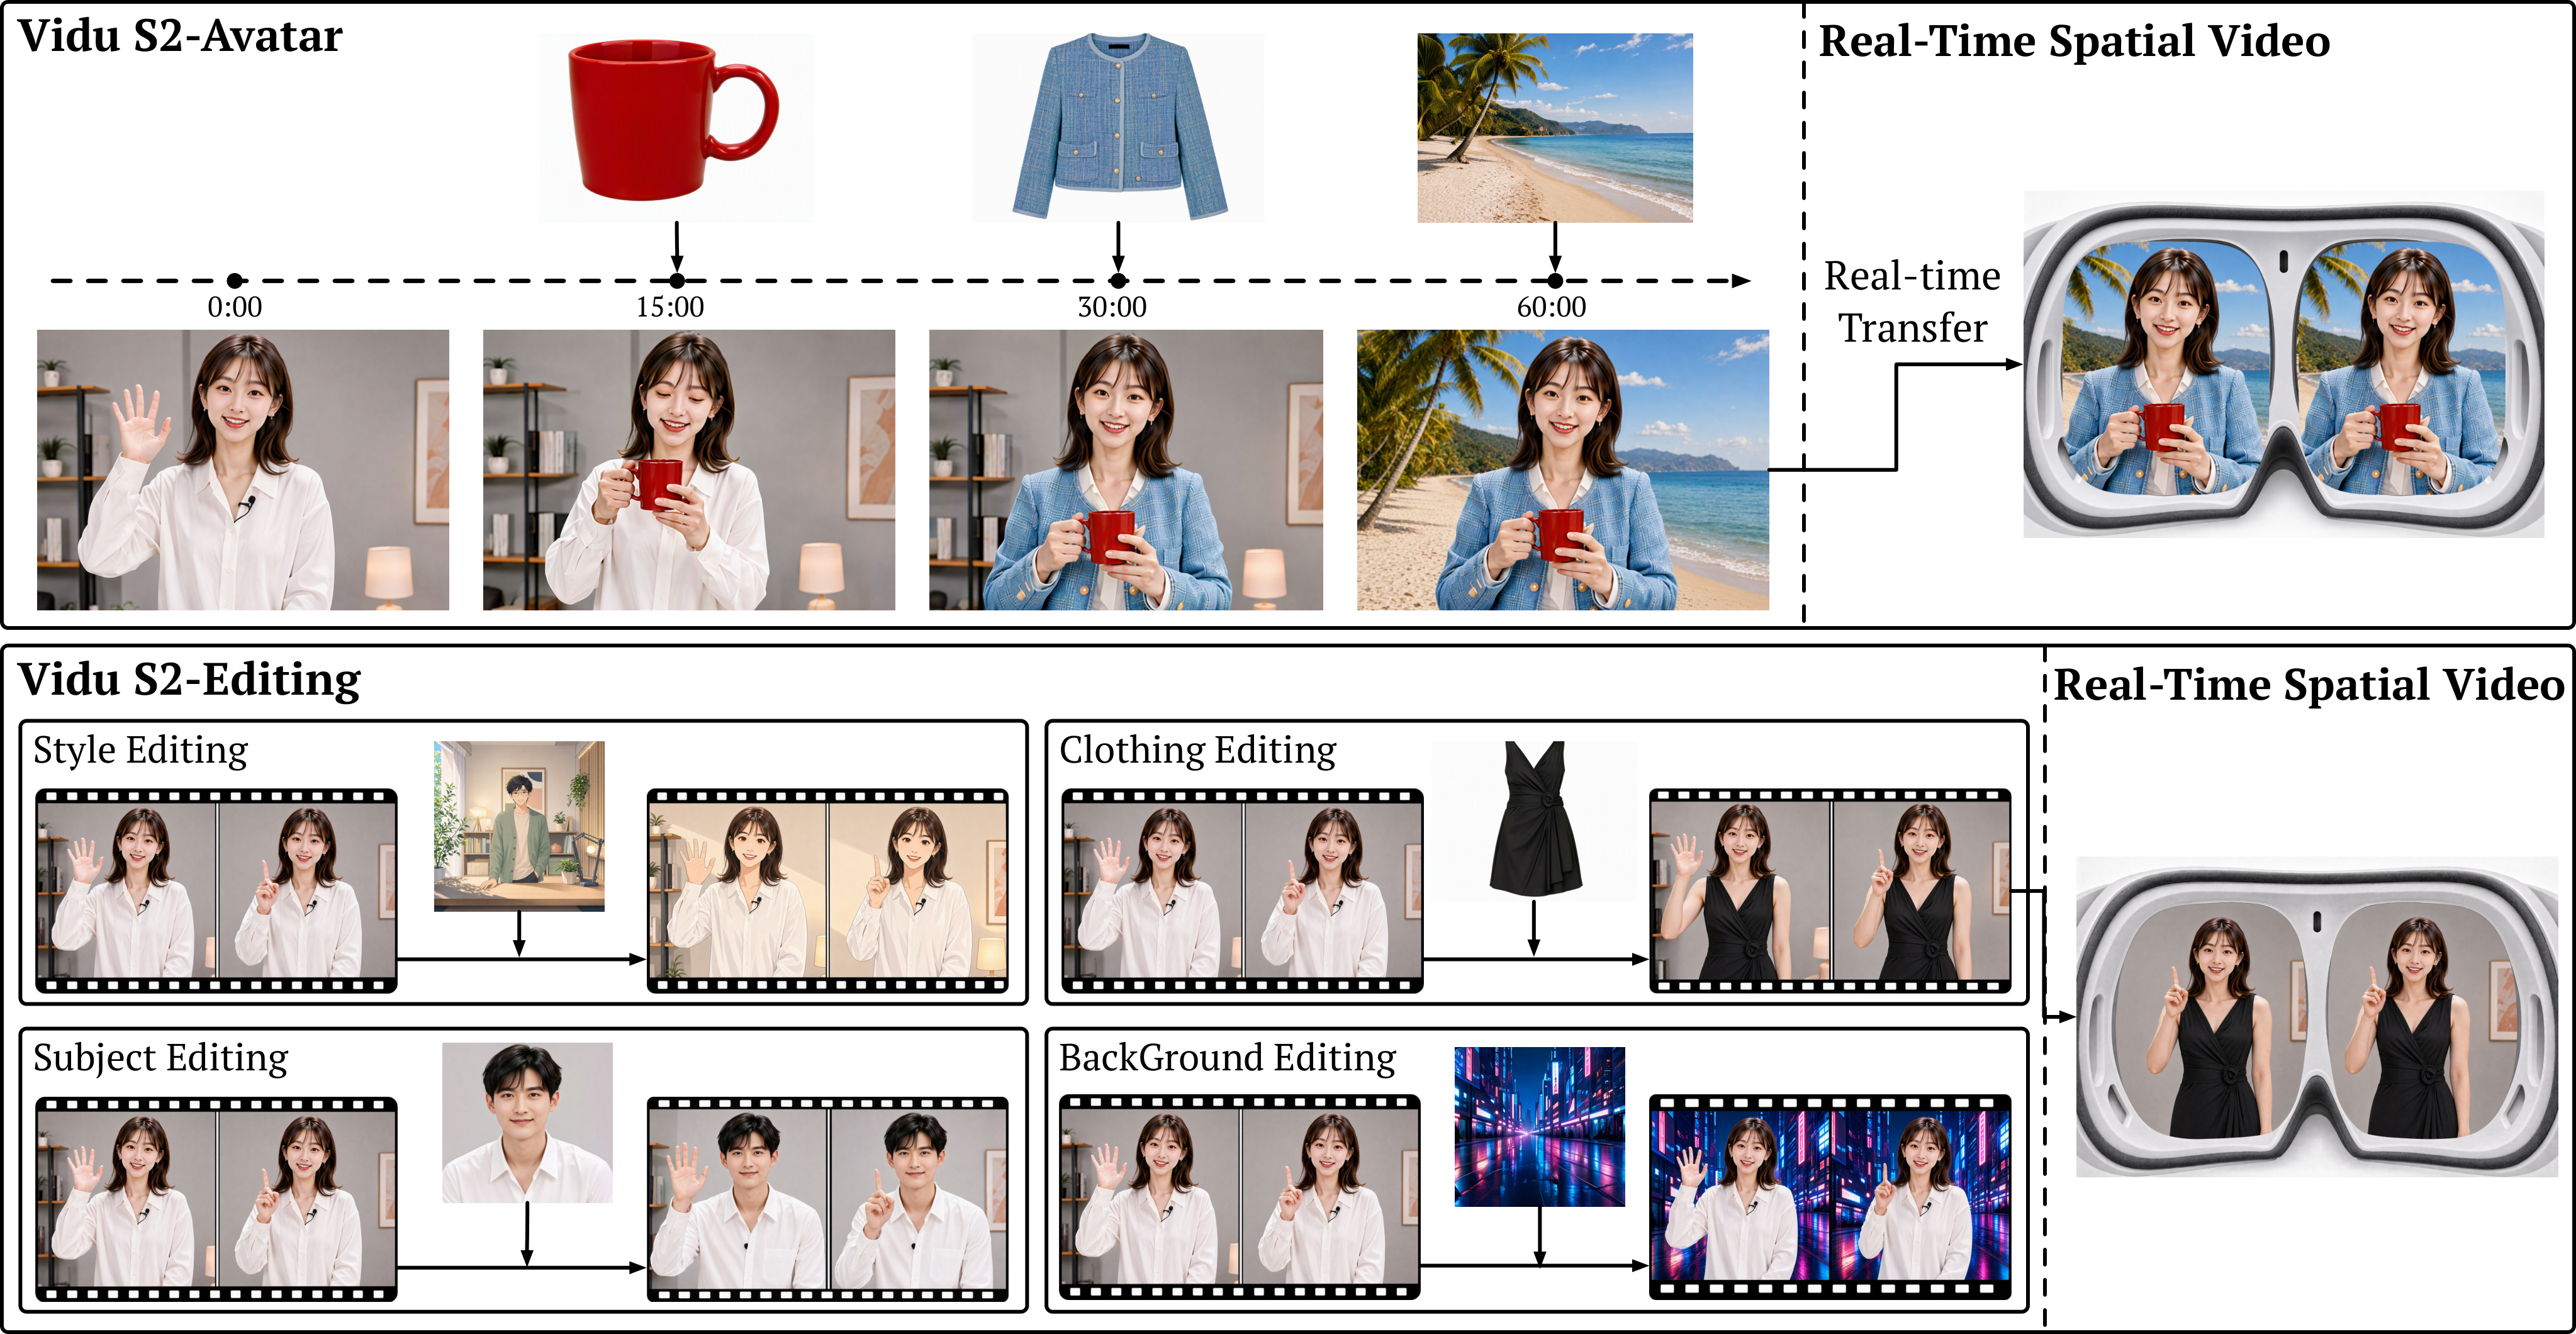
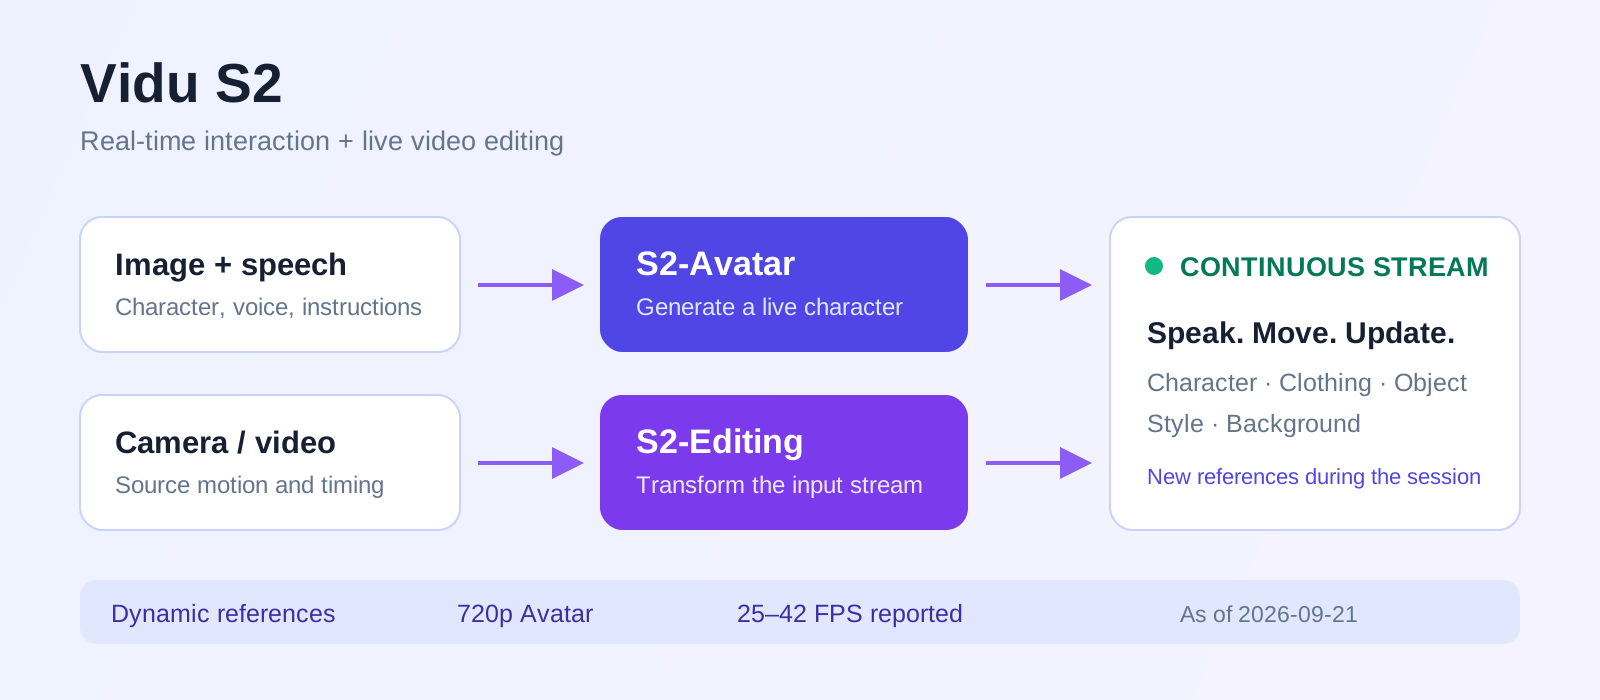
Vidu S2 的技术报告《Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation》于 2026 年 9 月 10 日提交 arXiv。生数科技于 9 月 15 日发布产品,9 月 16 日发布英文新闻稿。S2 的核心目标是让生成中的视频持续接受语音、文字、参考图和视频输入,并在同一条视频流里改变状态。
| 项目 | 截至 2026-09-21 的状态 |
|---|---|
| 开发方 | 生数科技 ShengShu Technology |
| 核心模型 | Vidu S2-Avatar / Vidu S2-Editing |
| Avatar 输出 | 720p;论文报告生成吞吐为 25–42 FPS |
| 交互能力 | 实时对话、动作控制、全身运动、动态增加参考图 |
| 编辑能力 | 风格转换、虚拟试衣、主体替换、背景替换 |
| 空间视频 | 已展示左右眼立体视频研究能力;不等同于标准公开 API |
| 开发与体验 | 已提供 API 文档及官方在线 Demo |
| 模型权重 | 未见公开 S2 checkpoint;官方 GitHub 不等于开放权重 |
S2-Avatar:从说话人像到全身互动
给一张人物图,S2-Avatar 可以生成持续说话和运动的角色。控制范围从表情、挥手扩展到站立、跳舞等全身动作;支持真人、动漫人物等角色形象,官方体验也展示宠物类角色。动作与外观变化发生在持续输出的视频中。
| 能力 | 交互示例 |
|---|---|
| 实时对话 | 与 AI 角色视频通话,通过语音或文字继续对话 |
| 动作控制 | 让角色站起来、挥手、跳舞 |
| 物品互动 | 对话中上传杯子或商品图片,让角色拿起并介绍 |
| 动态换装 | 上传服装参考图,要求角色穿上这件衣服 |
| 场景切换 | 上传咖啡馆参考图,让角色进入新的背景 |
| 状态保持 | 完成拿杯子的动作后,后续微笑和说话时继续持杯 |
这些是官方展示的能力范围,不代表任意图片、动作和长时间会话都能稳定完成。做直播、导购或陪伴产品时,需要用自己的角色、商品和交互脚本验证。
角色转身、摆动手臂,展示连续动作。官方宣传页预录短片。
角色拿起并戴上太阳镜,展示配饰互动。官方宣传页预录短片。
短片来自官方宣传页,卡片显示实际文件尺寸与时长;预录演示不用于测量交互延迟,也不代表 API 的原始输出规格。
S2 相比 S1 升级了什么
| 项目 | Vidu S1 | Vidu S2 |
|---|---|---|
| 输出分辨率 | 540p | Avatar 720p |
| 实时生成 | 支持 | 论文报告 25–42 FPS |
| 说话人像 | 支持 | 保留并增强表情与动作 |
| 大幅全身运动 | 指令跟随受限,跳舞较困难 | 加强全身动作与舞蹈 |
| 生成中更新参考图 | 开始后参考图固定 | 支持动态更新 |
| 换装与物品互动 | 受固定参考与动作能力限制 | 支持运行中引入衣服、物品和场景 |
| 编辑输入视频流 | 不支持 | 由 S2-Editing 提供 |
| Spatial Video | 本次报告未列为 S1 能力 | 展示实时空间视频研究方案 |
720p 与 25–42 FPS:画质、吞吐和延迟
S2-Avatar 用低分辨率 Backbone 处理运动、时间关系和较长的历史状态,再用单步 Refiner 恢复高分辨率细节。前者负责持续视频的结构,后者补充人脸、衣服和纹理;论文报告该方案能维持 720p 的实时输出。
低分辨率 Backbone
  → 单步 Super-Resolution Refiner
→ 720p 视频流评估产品体验时,应分别测首帧时间(TTFF)、说完一句话到角色回应的延迟、打断后的恢复时间,以及参考图切换时间。论文结果不能替代具体服务区域和部署链路的测量。
Self-Replay Forcing:减少长视频误差积累
自回归视频会把已经生成的片段作为后续条件。前面的小错误可能继续传递,最终表现为脸部变化、服装漂移或背景不稳定。Self-Replay Forcing(SRF)让训练更接近真实运行时看到的历史。
- 先让当前模型按实际推理方式,连续生成较长的轨迹。
- 对模型自己生成的片段重新加噪,使用这些并不完美的历史做因果 Replay。
- 在 Replay 阶段训练,使后续片段的损失能够影响前面的片段表示;原始 rollout 本身不保留完整反向传播图。
这样模型能学习处理自己产生的误差,改善长时稳定性。它的价值是减少累积错误,并不构成任意时长、任意交互都不会漂移的保证。
S2-Editing:实时修改摄像头与视频流
Editing 接收已有的视频流,并按文字指令或参考图修改外观。输入人物转身、抬手或移动时,输出应继续跟随输入的动作和时间轴。
| Editing Type | 功能 | 典型输入 |
|---|---|---|
| style_transfer | 画风转换 | 把摄像头画面变为动漫或水彩风格 |
| virtual_tryon | 虚拟试衣 | 用白色夹克参考图改变人物服装 |
| subject_replacement | 人物 / 主体替换 | 用参考角色替换原视频中的主体 |
| background_replacement | 背景替换 | 用新的场景参考替换原背景 |
Frame-Aligned Attention 如何保留动作
目标帧读取同一时刻的输入帧,参考图则为各帧提供外观条件。这种 Frame-Aligned Attention 设计把姿势、表情、相机运动和时间进度交给原视频约束,让模型重点改变服装、身份、风格或背景。实际输出仍需检查手部、遮挡和边界细节。
直播期间可以更新参考图或场景,例如从白衬衫切换成牛仔外套。官方 API 将切换描述为通常在数秒内完成,所以动态更新不意味着上传后下一帧就完成换装。
同一街景中的人物切换为像素与动漫画风。官方宣传页预录短片。
人物保持在同一场景,服装随演示切换。官方宣传页预录短片。
动态参考图与 VLM Agent
传统参考生视频通常先确定参考图,再生成一段完成的视频。S2 可以在生成过程中继续加入人物、衣服、商品和场景,使同一条视频流持续响应新的条件。
参考图 A → 持续视频流
                 ↓ 新指令 + 参考图 B
             更新外观 / 动作
                 ↓ 参考图 C
             继续生成并保持状态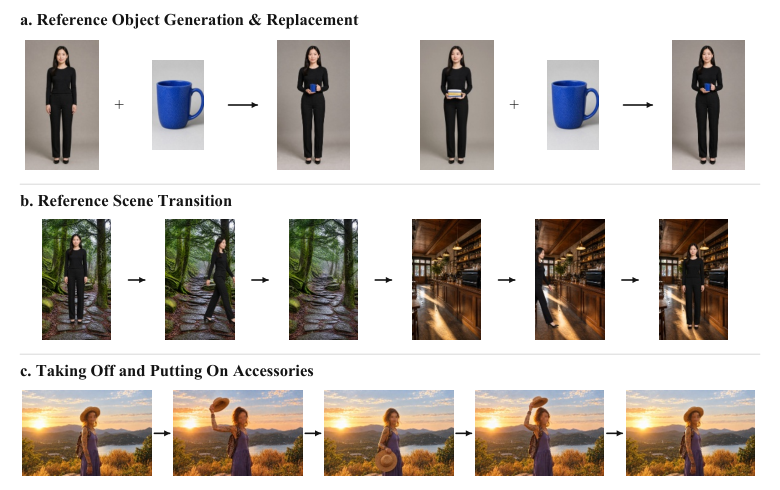
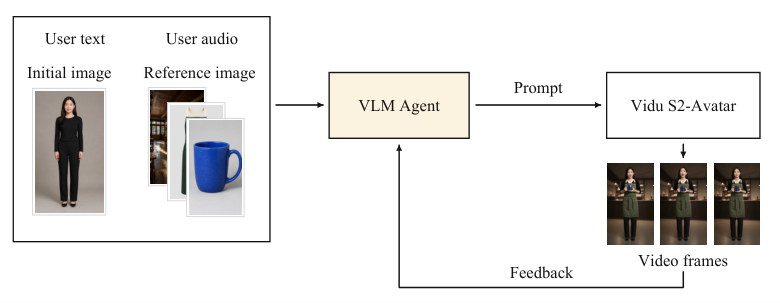
官方方案还引入 VLM Agent:理解指令和参考图,组织动作提示,再观察生成画面是否完成目标。如果角色尚未拿起杯子,就调整后续提示;完成后继续跟踪持杯状态。这是一种带视觉反馈的控制循环。
Spatial Video:左右眼空间视频探索
技术报告展示把 Avatar 或 Editing 的输出转换为同步左右眼视图,并传入 VR 头显。对单目视频,可以在生成或编辑之后进行深度估计和立体变换;对于原本就是双目的输入,可以联合编辑两个视角,再拆回左右眼。
单目:生成 / 编辑 → 深度估计 → Stereo Warping → 左 / 右眼
双目:左 / 右眼输入 → 联合编辑 → 左 / 右眼输出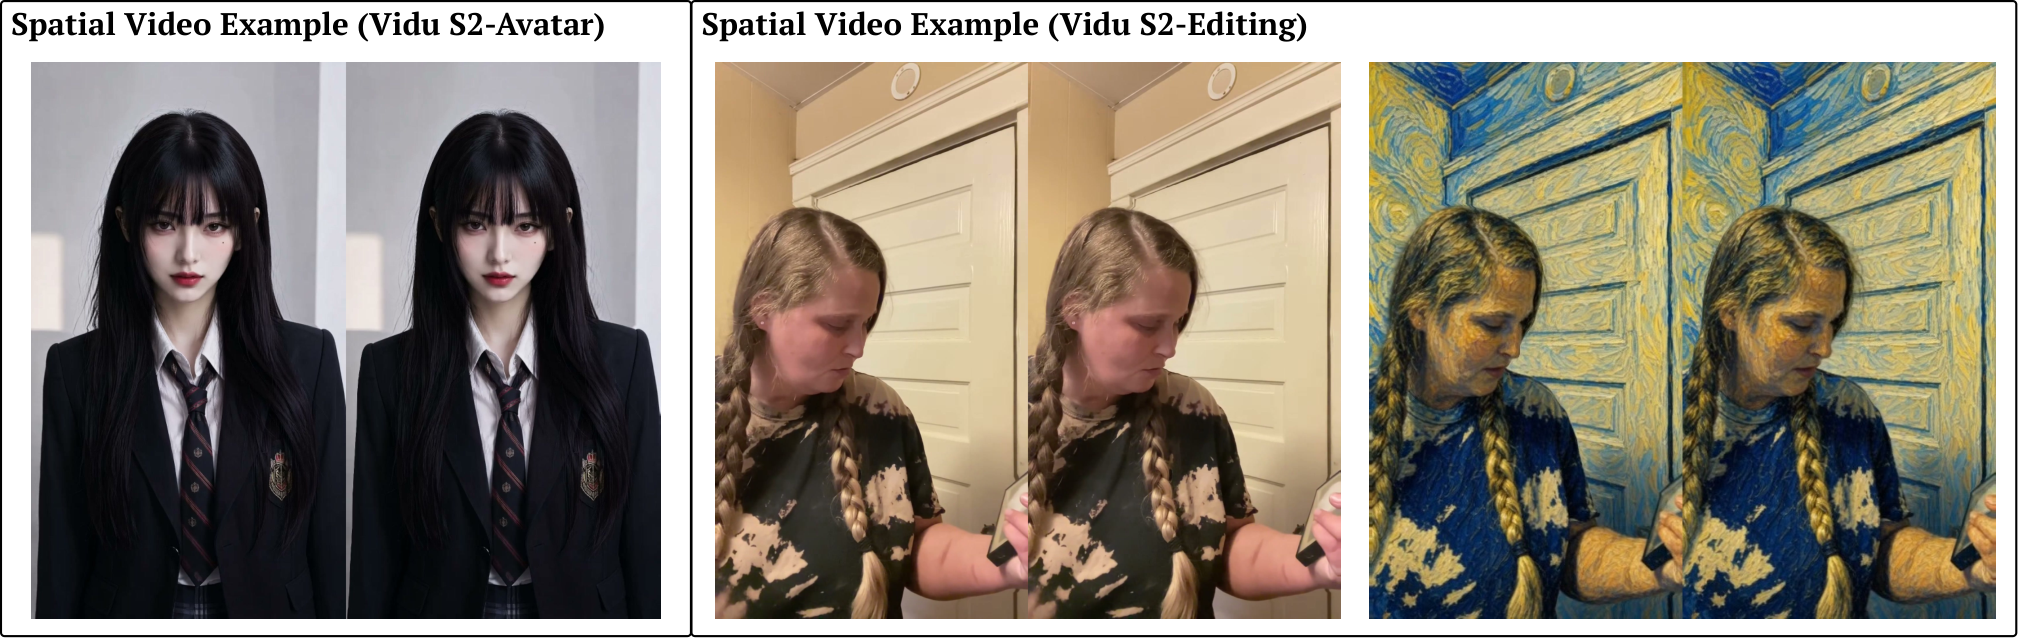
潜在应用包括 VR / AR / XR、空间计算、AI 陪伴和游戏 NPC。截至本页资料日期,应将这部分视为研究展示;尚未确认与 Avatar、Editing 同等完整的标准公开 Spatial API。
Benchmark:官方报告了什么
StreamAV-Bench · Avatar
论文表 1 中,S2-Avatar 在列出的九项指标上均取得最佳值。下面节选五项,涵盖视觉质量、音画同步和长时一致性。
| 模型 | Visual Aesthetics ↑ | Visual Quality ↑ | AV Sync ↓ | Subject Consistency ↑ | Background Consistency ↑ |
|---|---|---|---|---|---|
| Live Avatar | 0.661 | 3.295 | 1.145 | 0.997 | 0.989 |
| Self-Forcing | 0.585 | 2.753 | 0.919 | 0.981 | 0.969 |
| Vidu S2-Avatar | 0.687 | 3.370 | 0.617 | 0.998 | 0.993 |
AV Sync 越低越好,它衡量音画同步误差,不是用户说话后的响应延迟。主体和背景一致性得分也不能解释成长期运行的成功率。
Sparkle-Bench · Editing
| 模型 | Overall ↑ |
|---|---|
| Kiwi-Edit 5B | 3.57 |
| Decart Lucy 2.5 | 3.67 |
| Vidu S2-Editing | 3.74 |
OpenVE + RefVIE · Editing
| 模型 | Joint Overall ↑ |
|---|---|
| Bernini-R 14B | 3.92 |
| Vidu S2-Editing | 4.26 |
ViViD 测试集 · 虚拟试衣
| 模型 | VFID_I ↓ |
|---|---|
| ViViD | 21.8032 |
| CatV²TON | 19.5131 |
| Vidu S2-Editing | 9.9515 |
VFID_I 越低代表生成视频与参考视频的特征分布更接近。试衣评估涉及视频画质和时间连贯性,实际应用还需要检查服装纹理、人体动作与手部遮挡。
Vidu S2 vs HeyGen / Runway:如何看偏好测试
论文内部配对评测比较了 Runway Character GWM-1、PixVerse Image Avatar 和 HeyGen。作者报告:S2 对 Runway 的 Overall Preference 为 85.7%,对 PixVerse 和 HeyGen 为 100%。这些比例仅适用于该评测的样本和协议。
论文描述了由 20 名受训评估者参与的内部评测。部分图表百分比呈 14.3% 步进,但仅凭步进无法确定完整样本量、聚合方式或置信区间,因此不能把结果改写成对所有使用场景的胜率。
选型时应使用相同角色、语音、动作脚本和会话时长,对照首帧、响应延迟、打断恢复、长时身份一致性和实际账单。现有结果表明 S2 有竞争力,还不足以支持“全面取代 HeyGen 或 Runway”的结论。
Vidu S2 API:四种接入模式
| 模式 | Vidu 提供什么 | 适合谁 |
|---|---|---|
| Avatar Real-Time | RTC、ASR、LLM、TTS 与 Avatar 渲染的一站式链路 | 快速搭建陪伴、教师、客服和销售数字人 |
| Avatar Component | 音频与动作输入 → Avatar 视频流 | 自行选择 LLM、ASR、TTS 与 RTC 的开发者 |
| Avatar Offline | 图片 + 音频 / 文本 + 动作时间线 → MP4 | 批量讲解、主播和广告视频 |
| Editing | 输入视频流 → 实时编辑后的视频流 | 直播滤镜、试衣、VTuber 和视频应用 |
用户语音 → ASR → LLM → TTS → Avatar 渲染 → RTC 视频
一站式链路由 Vidu 提供你的 ASR / LLM → 你的 TTS → 音频 + 动作控制
↓
Vidu S2 Avatar
↓
你的 RTC 视频应用Component 可以与开发者选择的语言模型和语音服务组合,例如 DeepSeek、GPT、Claude 或 ElevenLabs;这表示架构上可自行集成,并非宣称这些厂商提供官方联合方案。
Component 的 RTC、音频和 WebSocket
Component 文档列出 Alibaba ARTC、Tencent TRTC、Agora 和 Volcano Engine RTC。WebSocket 传递音频、打断、转写和控制信号,RTC 负责实时媒体流;实际接入需要协同管理会话与播放。
| 音频参数 | 文档要求 / 建议 |
|---|---|
| 编码 | PCM s16le |
| 采样率 | 24 kHz |
| 声道 | Mono(单声道) |
| 推荐音频分帧 | 20 ms / 100 ms |
浏览器接入可使用会话的 client_secret 建立 WebSocket,再通过 RTC SDK 发布或订阅流。长期 API 密钥应留在服务端,由后端创建会话并发放客户端凭据。
Editing API 与直播推流
Camera / 视频输入 → RTC → Vidu S2-Editing
                                  ↓
                           编辑后视频 → RTC / RTMP
Editing 参数支持 rtmp_urls,用于把输出转推到多个 RTMP 地址。这为接入 YouTube Live、Twitch、电商直播以及支持 RTMP 的其他平台提供了路径;目标平台仍需要相应直播权限和有效的推流地址。
运行中更新参考图和 scenario 时,需要处理切换过程中的状态,不能假设每次修改都会在下一帧生效。
Vidu S2 API 价格
以下为截至 2026-09-21 的国际版 API 标价。1 Credit = US$0.005;分钟价按秒价乘以 60 换算。税费、用量之外的容量费用,以及自行集成的语音、LLM、RTC 等服务费用需另计。
| 模式 | Credits / 秒 | USD / 秒 | USD / 分钟 |
|---|---|---|---|
| Avatar Real-Time | 1.5 | $0.0075 | $0.45 |
| Avatar Component | 1 | $0.005 | $0.30 |
| Avatar Offline | 1 | $0.005 | $0.30 |
| S2-Editing | 1 | $0.005 | $0.30 |
Real-Time Avatar 的前 10 个 Voice Clone 免费,之后每个 899 credits,即 US$4.495,约 US$4.50。这是 S2 价格栏内的语音克隆政策。
并发容量:前 5 路与额外会话
例如,若按该标价购买第 6 路并发,新增容量费用就是 US$2,080 / 月,视频使用仍按秒计费。并发是同时运行的会话数量,不是累计注册用户数。价格表合并展示容量政策;具体模式的共享额度、适用范围和企业合同应向 Vidu 确认。
总预算 ≈ 计费秒数 × 对应秒价
       + 超出免费容量的并发费用
       + 自有 LLM / TTS / ASR / RTC / 存储费用
       + 适用税费
Offline Avatar:图片、音频与动作时间线
离线模式支持把图片、音频或文本与动作时间线组合成 MP4,适合新闻主播、AI 教师、产品讲解、UGC 广告和批量短视频。动作可指定发生的时间范围。
{
  "text": "Welcome to our channel",
  "timeline": "{\"actions\":[{\"text\":\"smile and wave\",\"time_range\":[2,10]}]}"
}
注意:API 的 timeline 字段是序列化后的 JSON 字符串,不是嵌套 JSON 对象。完整请求还需配置图片、模型和相应参数。任务结果 URL 默认约 24 小时过期,生产应用应及时下载并保存到自己的存储。
在线体验、免费额度、iframe 与开放权重
官方 Demo 位于 vidu.com/vidu-stream。自定义人物需要登录、账号验证和上传照片。公开资料没有给出可长期依赖的“每账号每天免费 X 分钟 S2”承诺,实际试用额度以账号界面为准。
截至本页资料日期,未找到官方公开的 S2 iframe embed API。开发路径是 REST API、WebSocket 和 RTC SDK;直接嵌入 Demo 网页不等于获得可商用、稳定的嵌入接口。
官方 Vidu-S GitHub 提供项目介绍、论文和相关入口,未见公开的 S2 checkpoint。可以阅读项目资料,但不能据此承诺免费下载模型或本地部署。
S2、Q3 与其他视频模型如何区分
| 路线 | 主要流程 | 更合适的比较维度 |
|---|---|---|
| Vidu Q 系列(如 Q3) | 文本 / 图片 / 参考 / 首尾帧 → 完成的视频 | 画质、镜头语言、时长、离线生成成本 |
| Vidu S2-Avatar | 语音 + 指令 + 动态参考 → 持续互动角色 | 响应速度、动作、打断恢复、身份与状态保持 |
| Vidu S2-Editing | 摄像头 / 视频流 + 编辑条件 → 持续输出 | 输入动作保持、外观编辑、切换延迟和时间一致性 |
Veo、Sora、Wan、Seedance 的常见成片生成工作流,更适合与 Q 系列按具体任务比较。评估 S2 时,仅比较一段 5–10 秒成片的美观程度,会漏掉持续交互这一核心价值。各品牌产品线会变化,比较应明确版本与模式。
S2 可以从 Streaming、Stateful、Interactive 三个角度理解:视频边生成边播放;角色需要维持身份、衣服和手中物品;运行中仍接受语音、文字、图像和摄像头输入。将它视作新的交互界面,是本页的应用判断。
应用场景
| 场景 | S2 的潜在价值 |
|---|---|
| AI Companion / Character Chat | 持续视频对话、角色表情和动作回应 |
| AI Tutor / 儿童互动角色 | 把讲解和实时角色表演结合 |
| 视频客服 / 数字导购 | 边回答问题,边演示商品 |
| 电商直播 / Virtual Try-On | 运行中换装、引入商品参考和试衣 |
| VTuber / AI Cosplay | 让真实动作驱动生成角色或实时风格化画面 |
| 游戏 NPC | 探索可以说话、动作并保持交互状态的角色 |
| 直播滤镜 | 修改输入视频的风格、主体或背景 |
| 空间计算 / VR | 探索左右眼立体角色体验;依赖后续产品化 |
限制与后续值得跟踪的指标
- 720p 适合部分移动互动场景,距离高分辨率直播、4K 大屏或影视工作流仍有差距。
- 生成吞吐不能代表完整语音交互延迟,需要在自己的链路测量。
- 长时身份、物品和环境状态仍可能漂移;动态参考切换也存在等待。
- 大规模服务必须同时计算按秒用量和并发容量;低秒价不等于低总成本。
- S2 权重尚未公开,Component 仍有 beta 标记;服务权限与接口可能继续演进。
- 现有 Benchmark 和偏好结果以作者报告为主,仍需要更多独立长期测试。
| 观察指标 | 为什么重要 |
|---|---|
| 1080p Avatar / Editing | 决定更高画质的互动和直播适用范围 |
| TTFF / Interaction Latency | 决定首次加载与对话回应体验 |
| Reference Switching Latency | 决定换装和场景过渡是否自然 |
| State / Object / Environment Persistence | 决定人物、商品和环境能否长期保持 |
| GPU / Session Cost 与并发价格 | 决定部署预算与服务毛利 |
| Multi-character / Camera Control | 决定多人互动、NPC 和镜头控制的拓展空间 |
| Spatial API / Web SDK | 决定空间视频的可用性和前端接入成本 |
这些是后续观察项,不是已宣布的功能或发布日期。就实时陪伴和 NPC 应用而言,状态保持与交互延迟是值得优先实测的两个指标。
常见问题
- Vidu S2 是普通 AI 视频生成器吗?
- 它主要面向持续实时视频。S2-Avatar 生成可互动角色,S2-Editing 编辑输入的视频流;另有 Offline Avatar 用于输出 MP4。
- Vidu S2 API 每分钟多少钱?
- 按 2026-09-21 国际版标价,Avatar Real-Time 约 US$0.45 / 分钟;Component、Offline 和 Editing 约 US$0.30 / 分钟。容量、外部服务和税费另计。
- 前 5 路并发免费代表可以免费使用吗?
- 不是。价格表免的是前 5 路并发容量费,视频用量仍计费。额外一路并发标价为 416,000 credits / 月,即 US$2,080 / 月,具体适用范围以服务条款为准。
- 25–42 FPS 是否意味着约 24ms 响应?
- 不是。FPS 是生成吞吐;完整对话还经过 ASR、LLM、TTS、视频生成和 RTC,需要单独测量端到端延迟。
- 能否用免费 iframe 把官方 Demo 嵌进网站?
- 尚未找到官方公开的 S2 iframe embed API。当前公开开发路径为 REST API、WebSocket 和 RTC SDK,Demo 试用额度也不是固定免费服务承诺。
- Vidu S2 是否开源,可以本地运行?
- 截至资料日期未见 S2 模型权重公开。官方 GitHub 的项目资料不能替代可下载 checkpoint 或本地推理实现。
- S2 是否比 HeyGen、Runway 更好?
- 作者内部偏好测试给出较强结果,但它不是所有场景的胜率。应根据延迟、动作控制、长时稳定性、打断恢复和实际费用进行同条件对比。
- 能否直接调用 Spatial Video API?
- 论文展示了空间视频生成与编辑方案,尚未确认完整的标准公开 Spatial API。不要把研究展示当成已开放接口。


